Mostrando entradas con la etiqueta Altera. Mostrar todas las entradas

miércoles, 28 de octubre de 2015

INTEL - ALTERA ... preocuparnos? alegrarnos?

Mucho se ha dicho de esta gran operación comercial. 

Para los que trabajamos con FPGAs y más aún para los que nos gustan ALTERA FPGAs, no deja de ser una preocupación. Y si a eso le agregamos que mientras estuve en Intel ví como vendían y compraban grupos enteros de diseñadores de IC como si nada, mi preocupación escaló a niveles insospechados :) ...

Encontré un interesante articulo al respecto de este tema. Creo que explica bastante claro, como siempre Kevin Morris, los teje y manejes, suposiciones y preocupaciones de lo que puede llegar a ser el futuro de esta unión. 

Les dejo acá el link del articulo: 

Altera’s Long Game 


Espero lo disfruten.... 

miércoles, 11 de marzo de 2015

Error: "cannot match operand(s) in the condition to the corresponding edges. . ." "An edge descriptor must be applied to an expression of size 1"


Introducción

Hace poco una alumna me pidió le revise su código Verilog porque tenía problemas y no encontraba como se originaba el error. Obviamente, la herramienta de síntesis que usaba generaba un mensaje de error, y obviamente ese mensaje daba muy poca idea de cual era el origen del problema. Lo primero que hice, y que a veces me da resultado, es sintetizar el código en la herramienta de la competencia, y .... lo mismo, mensaje de error encriptado. Lo segundo que normalmente se hace en estos casos es "googelar" el mensaje de error y ver que se encuentra al respecto.... No encontré nada... No me quedaba otra que estudiar el tema y ver que originaba el error. 
Detallo entonces debajo problema, mensajes y finalmente solución ....

Mensajes de Error Encriptados

ISE genera el siguiente mensaje de error: 

"ERROR:Xst:904 - "../../RTL_Src/semaforo.v" line 64: An edge descriptor must be applied to an expression of size 1."

El mensaje de error de Quartus: 

"Error (10200): Verilog HDL Conditional Statement error at semaforo.v(64): cannot match operand(s) in the condition to the corresponding edges in the enclosing event control of the always construct"

Las líneas del código correspondiente al número de línea indicado por el mensaje de error son las siguientes: 


A simple vista no se ve nada raro en el código. Revise muchísimas veces cada instrucción, cada simbolo, cada nombre y todo se veía perfectamente bien. 
Por supuesto una de las cosas que hice fue, por ejemplo, ir a la referencia del mensaje de error generado por la herramienta. En el caso del ISE el error es Xst:904, 

al hacer doble click en el link del error aparece: 


 Que ayuda, no? !!!

Quartus, directamente no tenía un link o explicación del error más allá del mensaje en sí. 
Bueno, después de dar tantas vueltas, como siempre la solución era muy sencilla. En realidad el problema no estaba en el código en sí, sino en la definición de clk y rst

Estas son las primeras lineas del código donde están definidas las E/S: 


Se dan cuenta del problema ?..... 

PROHIBIDO seguir leyendo sino encuentran el error :) ....

Por ahorrarse unas líneas de código, clk y rst fueron definidos en la misma línea que los vectores de dos bits sensor y boton.... por lo que clk y rst en realidad están definido como vectores de dos bits, por eso la instrucción negedge o posedge no puede determinar cual edge ejecutar. 

Como siempre una vez encontrado el error, uno dice: "Como no lo encontré antes!", "Que facil la solución", etc. etc, ... Lo que sí me parece extraño es que los compiladores no puedan generar un mensaje de error más sencillo, con mejor indicación del problema y una mejor guía de la solución.

Bueno, espero que les sea útil este artículo. 


jueves, 5 de marzo de 2015

Generador De Secuencia Binaria Pseudo Aleatoria (PRBS/LFSR)


Introducción

La generación de una secuencia pseudo aleatoria de números binarios es muy útil en ciertas ambientes de test y desarrollo. Un generador de secuencia binaria pseudo aleatoria, SBSA, (en  inglés,  Pseudo Random Binary Sequence, PRBS) es un circuito que genera una seria de números binarios de n-bits, un número por ciclo de reloj,  sin seguir un patrón determinado, pero que se repite luego de 2n-1 ciclos de reloj. Por lo general un PRBS se implementa como un registro de desplazamiento de realimentación lineal (en ingles Linear Feedback Shift Register, LDFSR). Dicho de otra manera con el término PRBS se describe lo que el circuito hace, mientras que con el término LFSR se describe como el circuito está implementado.

En esta nota técnica se describe en VHDL un LFSR que genera la secuencia binaria pseudo-aleatoria. Se presentan en VHDL distintos ejemplos de código y su implementación en FPGA. Finalmente se detalla un ejemplo de código VHDL parametrizado a fin de tener un PRBS genérico.

----------------------------------------------------------------------------------------

Me pasó de nuevo.... Comencé a escribir este blog, investigué, y encontré que hay de todo, por todos lados, pero nada en un solo lugar respecto de este tema. Otra vez, junté todo lo consideré importante, mas mi experiencia, etc, etc, y me quedaron unas cuantas páginas escritas, las cuales creo que la manera mas conveniente de presentárselas es a travéz de un buen documento. Podes bajar el pdf en este -link- 

Clq duda... solo preguntame... :)  

lunes, 9 de febrero de 2015

Partición de Diseño Basada en Dominio de Reloj

Introducción

Cuando el sistema a diseñar tiene varios módulos y a su vez cada uno de estos módulos tiene su propio reloj, y los módulos interactuan entre sí, es conveniente realizar lo que se llama partición del diseño basado en dominio de reloj, y seguir un par de simples reglas con respecto al modo de realizar la partición como así también con respecto al nombre de las señales de E/S, y de las señales de comunicación entre módulos.

Partición del Diseño

Supongamos tenemos un sistema como el que se muestra en la siguiente figura:


En este caso el sistema se ha dividido en tres módulos, A, B y C. Esta división está basada en función de los distintos relojes que tiene el sistema y en la funcionalidad de cada módulo; por ello cada módulo en este partición tiene su propio reloj. Así, cada módulo tiene lo que comúnmente se llama su propio dominio de reloj (clock domain). 
Esta partición de un sistema basada en dominio de reloj es muy importante por diversos motivos, principalmente facilita el trabajo de la herramienta de síntesis, mejora las tareas de las herramientas de cálculo de frecuencia máxima (Static Timing Analysis), ahorra tiempo en la herramienta de place and route. Otra ventaja de este tipo de partición, es que  ahorra mucho tiempo de procesamiento de CPU en sistemas complejos.

Sincronizadores

Al hacer la particion basada en dominio de reloj, y si los distintos módulos deben interactuar entre sí es necesario realizar algún tipo de sincronización entre las señales de comunicación entre módulos, ya que cada señal tiene su propio reloj. Esta sincronización puede ser realizada mediante sincronizadores o mediante FIFOs (no es el objetivo de este blog explicar los diferentes métodos de sincronización). Así por ejemplo, si se desea comunicarse una señal del módulo A con el módulo B, es necesario un sincronizador que sincronice la señal proveniente del módulo A basada en el reloj aclk, con el reloj bclk del módulo B. Del mismo modo para comunicarse o transferir datos desde el módulo B al módulo A, es necesario un sincronizador para pasar del dominio bclk al dominio aclk
De este modo todos los módulos principales tiene solo un solo reloj, mientras que los módulos sincronizadores, tienen múltiples relojes. 

Nombre de Señales

Con este tipo de partición es fácil seguir una convención para el nombre de las señales. Así, todas las señales que solo son controladas por un solo reloj, son definidas con nombres referenciando a ese dominio de reloj. Por ejemplo las señales del módulo A que solo son controlada por el reloj de A, aclk, se pueden nombrar comenzando con la letra a (referenciando al módulo A), así se puede nombrar la señal adata, aadrr, aen, etc., como también bdata, baddr, ben, etc, para las señales controladas por el dominio de reloj del modulo B (bclk). 
Por otro lado las señales que cruzan los dominios de reloj (a travez de los sincronizadores) deberían ser nombradas de forma que sea fácil de deducir el origen y el destino de la señal. Por ejemplo, si la señal ack debe cruzar del dominio bclk al dominio aclk se podría denominar b2a_ack
Usando este tipo de nomenclatura fácilmente se puede identificar cuales son las señales que cruzan diferentes dominios de reloj. Una de las grandes ventajas de esto es que se puede escribir la respectiva restricción (constraint) de false path para facilitar el trabajo de la herramienta de análisis de tiempo estático (Static Timing Analysis). 

Otras Ventajas de Partición por Dominio de Reloj

Ademas de las ventajas mencionadas anteriormente, este tipo de partición facilita el trabajo de floorplanning de la herramienta de síntesis, y como consecuencia se puede llegar más fácilmente a una reducción de área, mejoramiento del rendimiento, e incluso reducir la potencia de consumo del sistema. 
También, al tener los módulos separados por dominio de reloj, las herramientas de síntesis actuales permiten que cada módulo sea optimizado individualmente (ya sea por área, velocidad o potencia). 

Es todo por hoy.....

Espero sea de utilidad.....

martes, 14 de octubre de 2014

Reduciendo el tiempo de compilación en Quartus II

Por defecto Quartus recompila todos los módulos .vhd/.v del proyecto que se está llevando a cabo, aún cuando lo único que se haya modificado haya sido un punto y coma en uno solo de los módulos .vhd o .v. 
Existe una opción que permite recompilar solo los módulos modificados, ahorrando así mucho tiempo de compilación. 
Los pasos a seguir para configurar Quartus para minimizar el tiempo de compilación son: 

Assignments menu -> Settings 

Compilation Process Settings -> Incremental Compilation , click para seleccionar Rapid Recompile opción ON.

Otra opción que permite reducir tiempo de compilación es configurar Quartus para que use todos los núcleos del procesador de la computadora que se esté usando. 

Compilation Process Settings -> Parallel Compilation -> Use All Available Processors

Una ultima opción, es decirle a Quartus que use Smart Compilation. Al usar Smart Compilation se saltean alguno de los pasos del Compiler, tales como Analysis y Synthesis (cuando estos no son necesarios para recompilar el diseño).  

Compilation Process Settings -> Smart Compilation, click para opción ON.


Nota: estas son soluciones muy simples para diseños simples . Para diseños complejos hay otras opciones y factores a tener en cuenta que los detallaré en otro blog. 


viernes, 11 de abril de 2014

Correcto uso de Reset en FPGAs y su Codificación en VHDL


Introducción


En esta nota técnica se describirán con bastante detalle los distintos tipos de reset que se pueden usar en un sistema digital, sus ventajas y desventajas, y cual de ellos es el más aconsejable a usar para tener un sistema más confiable.

A pesar de que el reset de un sistema es un tema crítico, pocas veces se le da la importancia que tiene y es usualmente uno de los aspectos ignorados en un diseño con FPGA. Un circuito de reset que no se comporte correctamente resulta directamente en un mal funcionamiento aleatorio del sistema. Y como ya sabemos, los problemas aleatorios, no repetitivos, de un sistema son los más difíciles de depurar.

Un diseño puede tener reset sincrónico o asincrónico. Normalmente la señal de reset es generada externamente al FPGA, por lo que es una señal asincrónica. Básicamente la señal de reset es una entrada al sistema que posibilita la correcta inicialización del mismo. Como así también, pueda forzar al sistema a ese estado inicial cuando haga falta (por ejemplo, cuando el sistema se ‘cuelga’, o se va de su normal funcionamiento). Esta señal asincrónica puede sincronizarse a través de un circuito sincronizador, para de este modo crear una señal de reset sin glitches y por lo menos de un ciclo de reloj de ancho. Sin embargo, como se detallará en los próximos puntos el reset totalmente sincrónico puede ocasionar alguna fallas aleatorias, por lo que se propone otro circuito a fin de hacer el sistema más confiable.


.........................................................................................................................................................

Comencé a escribir este blog, investigué bastante, y me encontré conque no hay algún lugar donde se pueda encontrar lo que yo considero importante de este tema. Por eso armé algo basado en mi experiencia, más una que otra información, y me quedó un blog kilométrico, que no creo conveniente publicar algo tan largo como un blog; por lo que sí te interesa este tema podes bajar el pdf desde este -link-

Espero te sea útil. 

Hasta pronto, y gracias por visitar mi blog. . . 

Cristian 

martes, 14 de mayo de 2013

ModelSim-Quartus: "Failed to find INSTANCE '/NA'"

Introducción

Como bien es sabido los mensajes de error dados por la herramientas que comúnmente usamos son bastantes encriptados, y por ende no fácil de darnos cuenta cual es el origen del mismo. Uno de estos casos es este mensaje generado por ModelSim cuando tratamos de ejecutar una 'gate level simulation", ya sea automáticamente desde Quartus o desde el mismo ModelSim:


Veremos en esta entrada del blog como se soluciona este error. 


Descripción


La simulación a nivel de compuertas, gate level simulation (también conocida como post-place and route simulation) es un paso importante para asegurarnos que el sistema implementado en el FPGA cumple satisfactoriamente los requerimientos de tiempo después de colocar (place) y rutear (route) la logica de nuestro sistema en el FPGA. Para ejecutar la simulación a nivel de compuertas, es necesario generar un archivo de simulación (netlist) con todos los retardos (logics y de ruteo) y simular el sistema con ese archivo (netlist).
Quartus tiene una manera de configurar la simulación a ejecutar de un modo bastante detallado. Para la simulación a nivel RTL el procedimiento fue explicado en este blog anteriormente.  
Para ejecutar la simulación a nivel de compuerta (gate level simulation) Quartus genera a partir del .vhd a simular y de la información provista por la herramienta de place & route (especialmente con los retardos, delays, incorporados) un archivo con extensión .sdo, (standard delay output,  usualmente llamado standard delay format, .sdf), que contiene toda la información de los delays lógicos y de ruteo, y un archivo .vho, que contiene toda la información del conexionado del sistema a implementar en el FPGA. Ambos archivos contienen todo lo necesario para llevar a cabo la simulación a nivel de compuerta. Para los que les interese pueden abrir los archivos generados en el directorio: 

.../tu_proyecto/simulation/modelsim/nombre_top_entity_.vho
.../tu_proyecto/simulation/modelsim/nombre_top_entity_.sdo

Pasos a Seguir

Si has intentado correr la simulación a nivel de compuertas es porque ya tienes el respectivo test bench escrito. Solo falta decirle a Quartus por medio de lo Altera llama NativeLink que el dispositivo bajo test esta identificado con el nombre de la instancia en el test becnh. 
Para configurar el proceso de correr automáticamente en ModelSim la simulación a nivel de compuertas llevá a cabo los siguientes pasos. 
1- Ir a Assignments -> Settings
2- La ventana de 'Settings' se abrirá. Seleccioná 'Simulation'.
3- Dentro de la ventana de 'Simulation', hace click en el cuadrado de 'Run gate-level simulation automatically after compilation'. 
La siguiente figura muestra los pasos 2 y 3. 


4- En la misma ventana 'Simulation', y en la parte inferior done dice 'Compile test bench', simple click en 'Test Bench'. 
5- La ventana 'Test Benches' se abrirá. Simple click en 'Edit'.


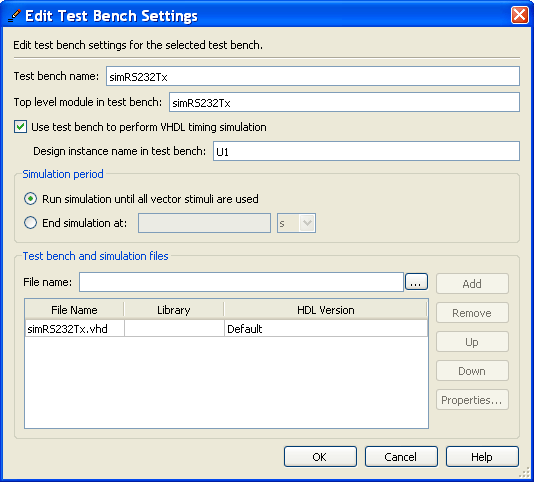
6- Ahora deberá aparecer la ventana titulada 'Edit Test Bench Settings'; mostrando el nombre del test bench que será usado en la simulación. En esta ventana seleccione 'Use test bench to perform VHDL timing simulation'. Y en la parte donde dice 'Design instance name in test bench' debes escribir el nombre de la instancia del componente en el test bench. Por ejemplo en el test bench tengo la siguiente instrucción de instanciación de componente: 


En el caso que estoy detallando, yo use U1 como nombre de la instancia. 
Hay que ser muy cuidadoso de verificar cual es el nombre de la instancia y escribirlo en "Design instance name in test bench". 


7- Click Ok. y cerrar cualquier otra ventana que haya quedado abierta. 
8- Ya puedes efectuar una simulación a nivel de compuertas usando


Nota 1: por favor acordate después de ejecutar una simulación a nivel de compuertas de borrar el archivo vsim.wlf generado por ModelSim, porque es inmensamente grande.
Nota 2: agradezco la inquietud de mis alumnos Mario Ruiz, y Germán González en este post. 
Nota 3: como podrán ver en el calendario me borre por unos meses.... bueno.. anduve haciendo otros trabajos no tan lindos como codificar en VHDL e implementar en FPGA..... así es q estoy muy contento de poder volver a mi temática favorita!!

domingo, 28 de octubre de 2012

Replicación de Lógica - Inserción de Buffer - Alta Cargabilidad (High Fan-Out)

Introducción

Entre las tantas tareas que llave a cabo la herramienta de síntesis, hay una que se encarga de revisar la cargabilidad (fan-out) de cada señal lógica.Por defecto existe un número límite máximo de cargabilidad permitido. Este numero básicamente depende de la familia del FPGA con que se este trabajando. Por supuesto existe la opción de incrementar ese número, aunque no es lo mas aconsejable. La mejor solución para casos en que la cargabilidad de una señal sea mayor a la permitida, es lo que técnicamente se llama replicación de la lógica que genera la señal de tan alta cargabilidad. La cargablidad de cada registro, compuerta lógica y cualquier otro elemento lógico es analizado por el compilador de la herramienta de síntesis. Si el numero de cargabilidad encontrado supera al establecido por el diseñador, el compilar replica el nodo fuente de la señal hasta que el número de cada copia esté por debajo del número máximo de cargabilidad permitido. 

Cargabilidad (Fan-out)

Fan-out es definido como el número máximo de entradas de componentes lógicos que pueden ser conectadas con la salida de otro componente lógico. De acuerdo al diseño o circuito que se implementa algunas señales internas del mismo (salidas) se conectan a las entradas de otros componentes. Esta cantidad de conexiones puede ser un número desde 1 hasta un numero muy alto (por ej. 10000), este es el números que se conoce como fan-out. No hace falta que uno sea el que lleva la cuenta de la cargabilidad de cada señal, todas las herramientas de síntesis detallan en su reporte las señales que tienen un alto fan-out. 
Por qué existe un número máximo de fan-out? El número conexiones máximas están limitadas,  por un lado, por la degradación que puede tener la señal de del alta cargabilidad debido a que la principal carga que ve la salida es la capacitancia de entrada de los componentes a los que está conectada; así mientras mas conexiones tiene la salida, más capacitancia, más tarda en subir (rise-time) y en bajar (fall-time) la señal. Al tardar mas en subir y en bajar, la señal sufre un retardo generado solo por la cargabilidad, de este modo el rendimiento del sistema puede verse reducido. Finalmente, en el caso de los FPGAs, otro problema de una señal con un número alto de fan-out es que crea dificultades para rutear la señal dentro del FPGA, a no ser que se use una ruta dedicada para la señal de alta cargabilidad. 
Normalmente las herramientas de síntesis de los distintos fabricantes tienen un valor de fan-out para todas las señal (valor global) configurado por defecto. Sin embargo, este valor puede ser sobrescrito usando ya sea restricciones en el archivo correspondiente, (.sdc para Altera; .ucf para Xilinx), o usando atributos de síntesis, cuyo nombre depende de la herramienta de síntesis que se use.  


En el caso de Synplify, la herramienta permite configurar el valor de fanout máximo desde una ventana de configuración: 
Project -> Implementation Options -> Device

en la opción Fanout Guide se muestra el numero máximo de fanout.


El valor configurado para fanout, se aplica a TODAS las señales del diseño, se por ello se lo denomina fanout global. Tal como se explico anteriormente este valor no puede ser demasiado alto, pero tampoco demasiado bajo. En este último caso se corre el riesgo que la herramienta de sintesis duplique lógica o inserte buffers sin realmente necesitarse. Ambos extremos afectan el ruteo y el rendimiento del diseño. 
Para sobrescribir el fnaout global e imponer un fanout distinto en un mas bajo nivel se puede usar el atributo:

syn_maxfan 

Este atributo se aplica a distintos niveles de jerarquía del diseño, descripto en el siguiente cuadro: 


Cuál es la diferencia entre límite duro y blando? 
En el limite blando la herramienta puede o no puede replicar la logica o introducir un buffer, una vez superado el valor límite. En el caso de aplicar syn_maxfan a un registro por ejemplo, si se supera el valor de fanout configurado por el atributo SI o SI la lógica es replicada o se agrega un buffer a la señal.  
A continuación se presenta un ejemplo de un valor alto de fanout que afecta el rendimiento máximo del sistema. Como puede apreciarse el retardo de ruteo es excesivamente largo, principalmente debido a un muy alto valor de fan-ou (seguramente también esta señal no esta usando un ruteo dedicado). 


Esta señal, sig, es un típico caso en el que un alto fanout está afectando la frecuencia máxima de funcionamiento del sistema, por lo que se debería replicar la lógica generada de esa señal.

Quartus Configuración y Atributo

El atributo que controla el valor de fanout máximo en la herramienta de síntesis del Quartus II maxfan
El valor global de fanout se configura en en el Assignment Editor

XST Configuración y Atributo

El atributo que controla el valor de fanout máximo en la herramienta de síntesis XST del ISE de Xilinx se denomina max_fanout
El valor global de fanout se configura en: 
Process -> Properties -> Xilinx Specific Options -> Max Fanout

Detalles Lógicos

La herramienta de síntesis a fin de cumplir con los requisitos del valor máximo de fanout, puede hacer dos cosas: 
- replicación de lógica
- introducción de un buffer


Replicacion de Lógica

Cuando el fanout de un registro o una lógica combinacional supera el valor configurado, la herramienta de síntesis reduce el fanout al replicar la lógica de salida, ya sea secuencial o combinacional.


Introducción de Buffer

Un buffer es introducido por la herramienta de síntesis cuando una señal de entrada al FPGA tiene un alto fanout. 


Replicación Manual

Teniendo en cuenta que no todas las señales con alta cargabilidad originan problemas de bajo rendimiento, se puede proceder a una replicación manual del componente con una alta cargabilidad. Para ello en el código VHDL o Verilog se describe el componente las veces que sea necesario. Un punto muy importante en estos casos, es el uso de atributos de síntesis para prevenir que la lógica replicada sea optimizada por la herramienta de síntesis. Para ello se usan atributos tales como syn_preserve, syn_keep (en el caso de usar Synplify).


Excepciones

Como siempre ocurre hay excepciones a estas reglas y algunas son las siguientes:
  • Se puede 'exigir' a la herramienta de síntesis que use un 'buffer' en lugar de replicar la lógica. En el caso de Synplify esto se logra configurando el atributo syn_replicate a valor lógico '0', ya sea globalmente, o sobre el modulo o sobre un registro en particular. Este atributo previene la replicación, por lo que el software usará buffers para evitar los problemas relacionados con un fanout muy elevado
  • Para especificar que un puerto de entrada, por ejemplo una entrada de reloj, no sea usada con un buffer, se puede usar el atributo syn_noclockbuf, sobre esa entrada. Esto se usa comúnmente cuando se esta muy al limite con el numero de buffers globales y se necesita el buffer para una senal que no tiene un alto fanout pero que tiene una restricción de tiempo muy critica. 
  • Para casos en que el rendimiento del sistema no se muy crítico, es decir cuando la frecuencia de trabajo del sistema es baja o muy baja, se puede directamente evitar cualquier replicación de lógica o introducción de buffer al configurar el valor de fanout a un numero muy alto.  
  • Otros atributos que se pueden usar para que la lógica no sea replicada y en su lugar se introduzca un buffer, son los atributos syn_keep y syn_preserve. syn_keep es usado cuando se quiere mantener una señal, mientras que syn_preserve se utiliza para preservar un registro. En ambos casos si se supera el numero máximo de fanout, un buffer sera introducido en lugar de replicar la lógica.
  •  

Conclusión 

Es importante resaltar que las señales con alta cargabilidad en un diseño  no deberían ser tocadas a menos que esté en riesgo el rendimiento del diseño, es decir que la técnicas detalladas mas arriba se deberían usar en caso que la señal que tiene alta cargabilidad este afectando la frecuencia máxima a la que se desea funciones el diseño
La cargabilidad de las señales es detallada en los distintos reportes presentados por la herramientas de síntesis, ya sea Synplify, Quartus, XST, etc. En función de ese número y de que si se trata de una señal que es crítica para el máximo rendimiento del diseño, es que se deben aplicar las técnicas presentadas en este blog, para sea replicar la lógica o insertar un buffer.

martes, 2 de octubre de 2012

Inicialización y Asignación de Vectores - Aggregate

 Introducción

Un punto de mucha importancia cuando se escribe código VHDL es la escritura en forma parametrizada del mismo. Esto significa usar los distintos atributos e instrucciones de VHDL a fin de evitar hacer uso de referencias fijas las que deberán ser cambiadas si se modifica el tamaño de algún dato o señal del código escrito. Así, las referencias a tamaños de un dato o señal deberían ser expresadas en términos de atributos de VHDL o parámetros definidos por el diseñador. 

Aspectos Prácticos

Para simplificar los ejemplos comenzaremos con la inicialización de una señal. La asignación de un valor a una señal de tipo arreglo (array) normalmente se hace de la siguiente manera: 

data_out <= "00000000";

Si bien esa asignación es correcta, no es la más adecuada si se quiere escribir el código de forma parametrizada. La misma función cumple la siguiente asignación conocida como aggregate: 

data_out <= (others => '0');

Que también se puede usar para inicializar a todos ‘1’:

data_out <= (others => '1');

Similarmente se puede escribir: 

data_out <= ( 0 => ‘1, 3 => '1, others => ‘0);

Para formar de este modo el dato “00001010”. 
Un error común cuando se escribe código parametrizado es que un aggregate no puede ser usado en una expresión y debe usarse con un objeto de tamaño conocido. Así, el siguiente código dará un error el ejecutarse: 

signal internal_bus: std_logic_vector(width-1 downto 0);
 . . .
output_bus <= x"FF" when (internal_bus=(others=>0)) else . . .


En este comparación el tamaño de internal_bus es conocido, pero no el tamaño del dato con quien se esta comparando internal_bus. Para solucionar este problema se usa el atributo ‘range para proveer el tamaño del objeto. 

output_bus <= x"FF" when (internal_bus=(internal_bus’range=>0)) else . . .

Otro manera de hacer algo similar a lo detallado en el ejemplo anterior, sería mediante el uso de una constante tal como se detalla a continuación: 

constant all_zero: std_logic_vector(width-1 downto 0) := (others => ‘0);

signal internal_bus: std_logic_vector (width-1 downto 0);
. . .

output_bus <= x"FF" when (internal_bus = all_zero) else . . .

Una nota con respecto al uso de aggregate, es que cuando se usa en un arreglo compuesto por solo un elemento, la asociación por nombre debe ser usada para especificar el valor. Por ejemplo: 

constant valor_ini: std_logic_vector(2 downto 2):= (2=>); -- correcto

constant valor_final: std_logic_vector(2 downto 2):= (0); -- incorrecto  

Finalmente quiero recordarles que un aggregate también se usa para asignar valores de señales a otra señal en particular. Ejemplo: 

signal a, b, c, d: std_logic;
signal tmp: std_logic_vector(3 downto 0);

 .. .

tmp <= (a, b, c, d);

De este modo tmp(3) toma el valor de a, tmp(2) el de b, tmp(1) el de c y tmp(0) el de d. En caso de querer cambiar el orden se lo debe especificar en la asignación, por ejemplo: 

tmp <= (3 => c, 2 => a, 1 => d, 0 => b);

Asi, tmp tiene los siguientes vlaores asignados (c, a, d, b).
Tambien se puede expresar un aggregate de la siguiente manera: 

tmp <= (3 => ‘1, 2 | 1 | 0 => ‘0);

tmp <= (3 => ‘1, (2 downto 0) => ‘0);

tmp <= (3=> ’1, others => ‘0);

tmp <= (1, ‘0, ‘0, ‘0, ‘0);  


Todas estas ultimas cuatro asignaciones son equivalentes.

viernes, 28 de octubre de 2011

Generando el Hex del ASCII para ROM/RAM usando Matlab

En un previo post , http://hdl-fpga.blogspot.com/2011/06/memorias-rom-fpga-vhdl-como.html, detallé la codificación en VHDL para inferir memorias ROM e implementarlas en FPGAs. Una de las partes mas 'aburridas' de esta codificación es primero pasar de la letra al ASCII y después del ASCII al Hex respectivo. Especialmente para el caso de un string o número muy largo, o varios strings. 
Por ello, en uno de mis últimos cursos que dicté uno de mis alumnos no quería 'aburrirse' realizando las dos conversiones, entonces uso sus conocimientos y me presentó una solución tan ingeniosa como efectiva: escribió una pequeña función en Matlab que hace no solo las mencionadas conversiones sino que también genera directamente la sintaxis VHDL respectiva para la asociación del arreglo ROM  con sus valores respectivos. Gracias Ihosvanni por evitar que nos aburramos !. Acá va un screenshot del .m:


Básicamente lo que hace este código .m es tomar tres mensajes, y convertirlos en ASCII y luego al Hex respectivo. Para este caso planteado el resultado de la ejecución es algo como esto: 

0=>x"56",1=>x"61",2=>x"6C",3=>x"6F",4=>x"72",
5=>x"65",6=>x"73",7=>x"20",8=>x"64",9=>x"65",
. . . . . .
51=>x"20",52=>x"21",others=>x"20"


Así, lo único que queda por hacer es copiar y pegar estos valores en el arreglo ROM declarado tal como se detalló en el previo bloq. 
Este .m se puede perfectamente adaptar a distintos casos, por ejemplo remover mensajes, agregar más mensajes, etc. Por supuesto tener la precaución de que si se remueve algún mensaje, se deben remover todas las referencias al mismo, si se agregan mensajes, agregar las referencias respectivas. También se puede usar para casos en los que se quiere inicializar una memoria tipo RAM con un arreglo definido tal como se detalla en el previo blog.

El código Matlab lo puedes bajar de este link: ascii2rom.m

Espero que sea de utilidad, si es así ... bueno, házmelo saber !